Actualités et médias
28 Oct 2026
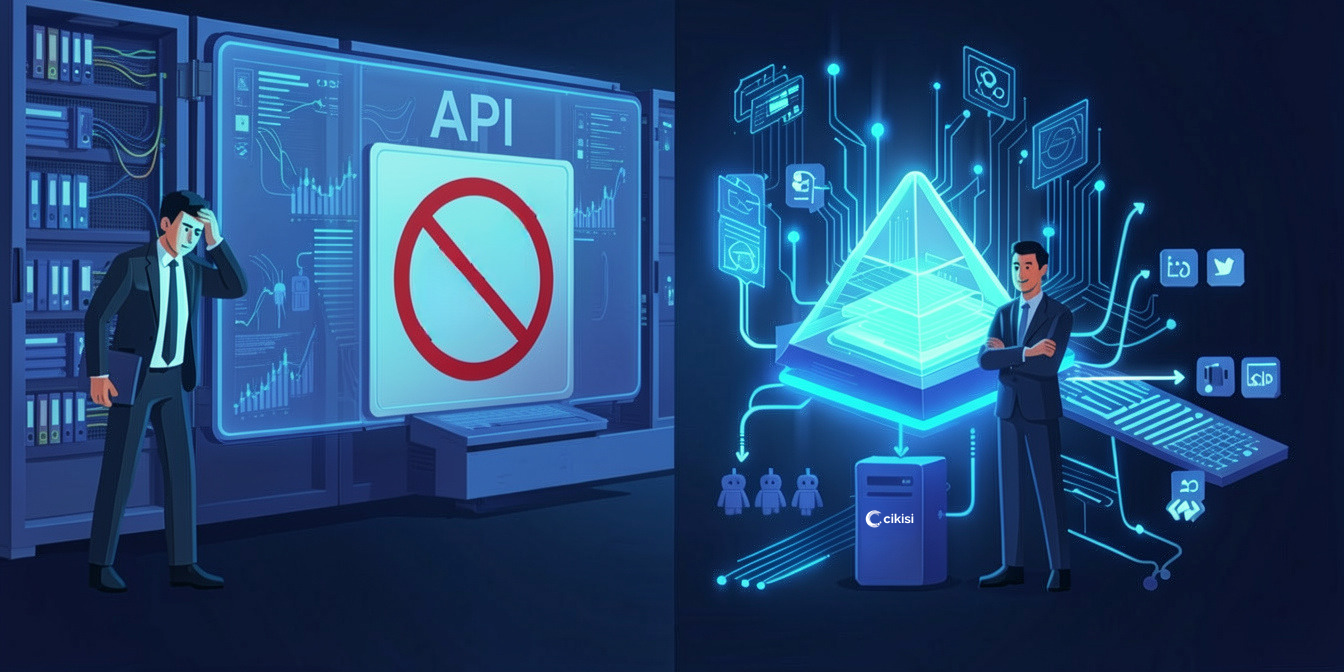
Les API de recherche ferment progressivement. Les grands acteurs technologiques renforcent le contrôle de leurs infrastructures. Dans ce contexte, les entreprises doivent s’interroger sur leur dépendance aux sources d’information externes et sur leur capacité à maîtriser leur propre approvisionnement informationnel.
Microsoft a retiré ses Bing Search APIs en août 2025. Google a fermé son API Custom Search JSON aux nouveaux clients et prépare la fin du service pour les utilisateurs existants.
Derrière ces décisions se dessine une évolution profonde du marché : l’accès aux données du Web devient plus contrôlé, plus encadré et davantage intégré aux écosystèmes propriétaires des grands acteurs technologiques.
Ces évolutions s’inscrivent notamment dans le développement de l’intelligence artificielle. Les index du Web représentent un actif considérable pour alimenter les modèles d’IA, les agents et les moteurs de réponse. Les grands acteurs ont donc intérêt à contrôler davantage les conditions d’accès à ces ressources et à privilégier des services intégrés plutôt que la distribution de résultats bruts. Pour les éditeurs de solutions et les entreprises utilisatrices, cela signifie une dépendance accrue à des infrastructures dont les conditions d’accès, les tarifs et les fonctionnalités peuvent évoluer à tout moment.
Avant d’analyser, de comparer, de détecter des signaux faibles ou de produire des recommandations, il faut disposer d’une matière première de qualité. C’est tout l’enjeu d’un infrastructure de web intelligence prête pour l’IA, capable d’alimenter les analyses comme les agents IA en données fiables et maîtrisées.
Or, une information incomplète, obsolète ou issue d’un nombre trop limité de sources fragilise toute la chaîne d’analyse, y compris lorsqu’elle s’appuie sur les technologies d’intelligence artificielle les plus avancées.
S’appuyer exclusivement sur des moteurs de recherche ou des fournisseurs d’API externes comporte plusieurs risques :
La réponse ne consiste pas simplement à multiplier les fournisseurs d’API. Elle repose sur la capacité à construire et à maîtriser sa propre infrastructure de collecte.
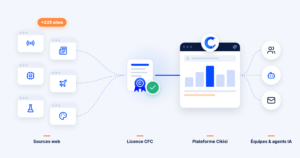
Cikisi a développé sa propre technologie de collecte et d’indexation de l’information, reposant sur plusieurs types de robots complémentaires dont des robots d’indexation et des robots intelligents.
Nos robots d’indexation explorent le Web et collectent les contenus issus des sources identifiées. Nos robots intelligents vont plus loin : ils contribuent à découvrir de nouvelles sources d’information, à étendre le périmètre de collecte et à enrichir continuellement le sourcing.
Cette complémentarité est essentielle. Elle permet non seulement de surveiller les sources déjà connues, mais aussi de découvrir de nouveaux gisements d’information et de détecter des sources pertinentes qui n’étaient pas encore référencées.
Une veille performante ne doit pas se limiter à surveiller ce que l’on connaît déjà. Elle doit aussi permettre de découvrir ce que l’on ne connaissait pas encore.
Cette maîtrise technologique permet de réduire la dépendance aux index généralistes et aux API de recherche externes, tout en conservant une capacité d’exploration et de collecte adaptée aux besoins spécifiques de chaque entreprise.
La maîtrise de la collecte prend toute sa valeur lorsque l’information peut être exploitée au-delà de la seule plateforme de veille.
Grâce à ses API et à son serveur MCP, Cikisi permet d’intégrer les données collectées dans les applications métiers, les systèmes d’information et les environnements d’intelligence artificielle des entreprises.
Les équipes et les agents IA peuvent ainsi accéder à une matière première informationnelle structurée et adaptée à leurs besoins, dans le cadre des modalités d’accès et d’utilisation définies par l’entreprise.
L’accès à une information publique ne signifie pas automatiquement que sa collecte automatisée, sa conservation ou sa réutilisation sont libres de toute contrainte.
Les entreprises doivent notamment tenir compte du droit d’auteur, du droit des bases de données, des conditions d’utilisation des sites, du RGPD et des éventuelles restrictions d’accès.
La conformité doit être intégrée dès la conception des dispositifs de collecte : identification et traçabilité des sources, gestion des accès, respect des droits et maîtrise des conditions de réutilisation.
La maîtrise technologique ne dispense pas de la maîtrise juridique. Les deux sont indissociables pour construire une infrastructure informationnelle durable.
L’intelligence artificielle transforme profondément les usages de l’information. Mais elle ne résout pas la question fondamentale de son approvisionnement.
Un modèle performant alimenté par des données incomplètes ne produira pas une intelligence fiable.
À l’heure où les grands acteurs technologiques renforcent le contrôle de leurs infrastructures, les entreprises ont tout intérêt à reprendre la maîtrise de leur chaîne informationnelle : diversifier leurs sources, développer leurs capacités de collecte, découvrir de nouveaux gisements d’information et garantir la qualité et la traçabilité de leurs données.
| L’information est la matière première de l’intelligence. La capacité à la découvrir, la collecter et la maîtriser constitue un véritable avantage concurrentiel. |
 Réserver une démo